ChatGPT Labrador: czy OpenAI ma własny indeks wyszukiwarki
Spis treści10 sekcji
Labrador to nazwa, pod którą w danych z interfejsu ChatGPT pojawia się własny indeks stron OpenAI. Sama nazwa nie jest oficjalna – OpenAI jej nie ogłosił. Istnienie indeksu OpenAI potwierdza za to we własnej dokumentacji: ChatGPT może szukać w „indeksowanej i zbuforowanej treści” OpenAI zamiast w wyszukiwarce na żywo.
Nazwę i budowę Labradora opisali badacze Peec AI we wrześniu 2026 roku. Z ich ustaleń wynika też, że ChatGPT wciąż korzysta z wyników Google i Microsoftu. Stan na 28.09.2026.
Co potwierdza sam OpenAI
OpenAI potwierdza istnienie własnego indeksu w dwóch dokumentach. Żaden z nich nie używa nazwy Labrador.
Pierwszy to pomoc ChatGPT o wyszukiwaniu offline dla firmowych przestrzeni roboczych. OpenAI pisze tam wprost, że ChatGPT korzysta wtedy z „indeksowanej i zbuforowanej treści” OpenAI i zwraca informacje ze stron, które są już „w indeksie albo pamięci podręcznej OpenAI”.
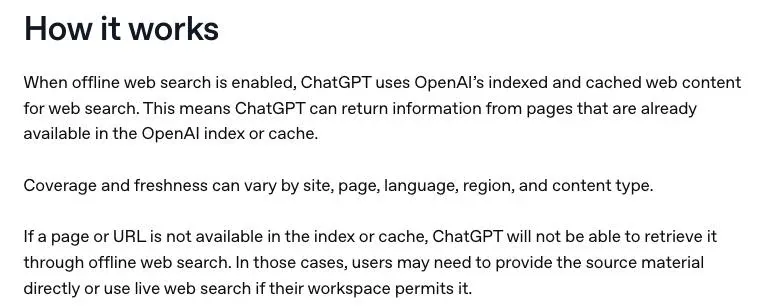
Pomoc OpenAI, „Offline web search for ChatGPT workspaces”, stan na 28.09.2026.
W tym samym dokumencie OpenAI zastrzega, że indeks nie obejmuje całego internetu. Zasięg i świeżość zależą od strony, języka, regionu i rodzaju treści. Nie ma też gwarancji, jak szybko konkretny adres zostanie odświeżony.
Drugi dokument to opis narzędzia wyszukiwania w API OpenAI. Parametr external_web_access: false uruchamia wyszukiwanie w trybie offline, tylko z pamięci podręcznej. Na ten parametr zwrócił uwagę w grudniu 2025 roku serwis LLMrefs.
| Co | Źródło | Status |
|---|---|---|
| ChatGPT ma indeks i pamięć podręczną stron | pomoc OpenAI o wyszukiwaniu offline | potwierdzone przez OpenAI |
| Wyszukiwanie tylko z pamięci podręcznej w API | dokumentacja API, external_web_access: false |
potwierdzone przez OpenAI |
| OAI-SearchBot zasila wyszukiwanie w ChatGPT | dokumentacja robotów OpenAI | potwierdzone przez OpenAI |
| Cel: 80% ruchu z własnego indeksu | zeznanie Nicka Turleya w procesie Google (2025) | zeznanie pod przysięgą |
| Nazwa „Labrador” i podział na indeksy tematyczne | analiza Peec AI (4.09.2026) | obserwacja badaczy |
Skąd wiadomo o Labradorze
Najpełniej opisał Labradora Tomek Rudzki z Peec AI w analizie z 4 września 2026 roku. Źródłem są zdarzenia, które serwery ChatGPT wysyłają do przeglądarki w trakcie generowania odpowiedzi (server-sent events).
Między 21 maja a 21 lipca 2026 roku w tych danych było pole result_source z czterema wartościami: Labrador, Bright, Oxylabs i SERP. Według Peec AI trzy ostatnie to zewnętrzni dostawcy, którzy pobierają wyniki z Google. Labrador to indeks OpenAI.
Peec AI opisuje Labradora nie jako jeden indeks, ale rodzinę indeksów tematycznych:
- ogólny indeks stron, PDF-y, YouTube i Wikipedia;
- wiadomości, osobno z ostatniej doby, ostatnich 7 dni i starsze;
- arXiv, czyli prace naukowe;
- wyniki lokalne, finanse, prawo i medycyna;
- zakupy i obrazy.
Według Peec AI indeks przechowuje pełną treść strony, datę pobrania i datę publikacji. To ten sam model, który od lat ma Google: ogólny indeks plus wyspecjalizowane indeksy dla różnych rodzajów treści.
Te ustalenia pochodzą z obserwacji danych, a nie z dokumentów OpenAI. OpenAI publicznie ich nie skomentował. Search Engine Watch zapytał firmę o Labradora – w dniu publikacji tekstu nie miał odpowiedzi.
Zakupy w ChatGPT: tu indeks widać najlepiej
Najwięcej śladów indeksu widać w wynikach zakupowych. W połowie sierpnia 2026 roku Rudzki zauważył w danych ChatGPT test A/B „prefer-index-over-serp-v3”, czyli „preferuj indeks zamiast wyników wyszukiwarki”. Obejmował około 8% rozmów.
Na 2 września 2026 roku działało co najmniej pięć eksperymentów zakupowych. W danych jednego z testów widać było, jak ChatGPT układa wyniki: wyszukiwanie po słowach (BM25), ocenę 400 kandydatów i wyszukiwanie wektorowe. To klasyczny układ nowoczesnej wyszukiwarki, a nie proste przekazywanie wyników od Google.
Jeśli sprzedajesz produkty, to właśnie tu najszybciej zobaczysz, czy ChatGPT pokazuje Twoją ofertę z własnego indeksu.
ChatGPT nadal korzysta z Google i Microsoftu
Własny indeks nie oznacza, że ChatGPT przestał korzystać z Google. W sierpniu 2025 roku The Information podał, że OpenAI pobiera wyniki Google przez SerpApi, firmę, która zbiera dane z wyszukiwarki. Abhishek Iyer, były inżynier Google, sprawdził to na stronach testowych obecnych tylko w indeksie Google – ChatGPT znał ich treść.
Malte Landwehr z Peec AI zrobił podobny test na stronie bez ruchu z Google. W dni, w które pytał o nią tylko ChatGPT, Search Console tej strony pokazywał skok ruchu. To mocna wskazówka, że ChatGPT w tym czasie wyszukiwał w Google.
Microsoft też zostaje w grze. Barry Schwartz z Search Engine Land pisze, że Web IQ, zestaw narzędzi Microsoftu do zasilania agentów AI wynikami Bing, obsługuje część odpowiedzi ChatGPT. Peec AI dodaje, że w trybie Deep Research ChatGPT wskazuje Bing jako źródło wyników.
Peec AI wymienia osiem źródeł, z których ChatGPT składa wyniki. Obok własnego robota OpenAI są to m.in. Bright i Oxylabs (wyniki z Google), Web IQ Microsoftu oraz Yelp i TripAdvisor przy wynikach lokalnych.
Plan był znany od 2025 roku
Budowa własnego indeksu nie jest tajemnicą od procesu antymonopolowego Google. Nick Turley, szef ChatGPT, zeznał w 2025 roku, że celem OpenAI jest obsługa około 80% ruchu z własnego indeksu. Dodał, że firma jest od tego celu daleko.
Z tych samych zeznań wynika, że OpenAI miał problemy z jakością wyników od Bing i prosił Google o dostęp do API wyszukiwarki. Google odmówił.
Tu jest rozbieżność. Peec AI, powołując się na dokumenty sądowe, pisze, że prace nad indeksem ruszyły w 2023 roku, a cel 80% dotyczył końca tamtego roku. Relacje prasowe z procesu podają cel bez tej daty. Nie udało mi się dotrzeć do pełnego stenogramu, więc datę startu traktuj jako niepewną.
OpenAI pobiera coraz więcej stron
Ślady budowy indeksu widać też w logach serwerów. Chris Long z Nectiv przeanalizował około 7 miliardów wizyt robotów OpenAI w danych Botify, od listopada 2024 do marca 2026 roku. Od premiery GPT-5 w sierpniu 2025 roku roboty OpenAI pobierają strony mniej więcej trzy razy częściej.
OAI-SearchBot, robot wyszukiwania, pobrał w tym czasie 3,5 raza więcej stron niż wcześniej i wyprzedził GPTBot, który zbiera dane do trenowania modeli. To przesunięcie z trenowania na wyszukiwanie.
Do Google OpenAI jednak daleko. W ostatnich 30 dniach badania, na tych samych stronach, roboty OpenAI zrobiły 887 milionów wizyt, a Googlebot 18,2 miliarda. To niecałe 5% ruchu robota Google.
Ile kosztowałby OpenAI indeks na miarę Google
Kosztu indeksu Google nie zna nikt spoza firmy. Alphabet nie podaje osobno wydatków na wyszukiwarkę, a sam indeks według Google obejmuje setki miliardów stron i zajmuje ponad 100 000 000 GB.
Są za to trzy liczby, które pokazują rząd wielkości:
| Kto | Ile | Na co |
|---|---|---|
| Microsoft | około 100 mld USD | Bing przez wszystkie lata, według zeznania Satyi Nadelli w procesie Google (2023) |
| Alphabet | 91,4 mld USD w 2025 roku, 195–205 mld USD planowane na 2026 | wszystkie inwestycje w infrastrukturę, głównie AI i centra danych, nie tylko wyszukiwarka |
| OpenAI | około 1,4 biliona USD w ciągu 8 lat | zobowiązania na centra danych i moc obliczeniową, według Sama Altmana (listopad 2025) |
Moja ocena: sam indeks to koszt liczony w dziesiątkach miliardów dolarów, nie w bilionach. Microsoft wydał na Bing około 100 mld USD i to wystarczyło, żeby zbudować pełną wyszukiwarkę. OpenAI deklaruje wydatki kilkanaście razy większe, choć głównie na trenowanie i obsługę modeli.
Pieniądze nie są więc główną barierą. Bing ma pełny indeks od lat, a udział w rynku wciąż niewielki. Różnicę robią trzy rzeczy, których nie da się kupić szybko.
- Dane o kliknięciach. Google od ponad 25 lat widzi, w co ludzie klikają i czy wracają do wyników. Pandu Nayak z Google zeznał, że system Navboost korzysta z danych z 13 miesięcy. Nowy indeks startuje bez tej historii.
- Dostęp do stron. Googlebota wpuszcza prawie każdy, bo bez niego nie ma ruchu z Google. Roboty AI coraz częściej są blokowane. Cloudflare od lipca 2025 roku domyślnie blokuje roboty AI u nowych klientów.
- Czas. Według Peec AI Turley zeznał, że nawet z danymi z indeksu Google OpenAI potrzebowałby co najmniej pięciu lat, żeby ocenić, czy da się obsłużyć 100% zapytań z własnego indeksu.
Jest jeden skrót. W wyroku z 2 września 2025 roku sąd nakazał Google jednorazowo przekazać uprawnionym konkurentom część danych z indeksu, m.in. listę adresów i daty ich pobrania. Część danych o interakcjach użytkowników Google ma przekazywać więcej niż raz. Uprawnione mogą być też firmy AI. Nie wiadomo, czy OpenAI z tego skorzystał.
Z ustaleń Peec AI wynika, że OpenAI nie buduje kopii Google, tylko rodzinę indeksów tematycznych – od zakupów po wiadomości i PDF-y – a resztę uzupełnia wynikami Google i Microsoftu.
Co jest plotką albo nadinterpretacją
Wokół Labradora narosło sporo przesady. Oto tezy, które krążą w branży, zestawione z tym, co wiadomo.
| Teza | Jak jest |
|---|---|
| „Labrador to oficjalny produkt OpenAI” | to wartość pola w danych, OpenAI nie używa tej nazwy publicznie |
| „ChatGPT nie potrzebuje już Google ani Bing” | nieprawda, testy pokazują, że korzysta z obu |
| „Wystarczy być w Bingu, żeby być w ChatGPT” | nieaktualne, ChatGPT ma własny indeks i kilku dostawców |
| „ChatGPT indeksuje cały internet” | OpenAI pisze, że indeks nie obejmuje wszystkich stron |
| „Da się zoptymalizować stronę pod Labradora” | nikt poza OpenAI nie zna jego sposobu oceny stron |
Uważaj na narzędzia i usługi, które nagle sprzedają „optymalizację pod Labradora”. Wiemy, że indeks istnieje. Nie wiemy, jak ocenia strony.
Co to zmienia w Twoim SEO
Moim zdaniem Labrador nie zmienia podstaw, tylko je wzmacnia. Żeby ChatGPT pokazał Twoją stronę, jego robot musi ją pobrać, a strona musi odpowiadać na pytanie lepiej niż inne. To to samo, czego wymaga Google.
Konkretnie:
- Nie blokuj OAI-SearchBot w robots.txt. OpenAI pisze, że strony, które go zablokują, nie pojawią się w odpowiedziach z wyszukiwania w ChatGPT. Zmiana w robots.txt działa po około 24 godzinach.
- Sprawdź logi serwera. Szukaj wizyt OAI-SearchBot i porównaj adresy IP z listą, którą publikuje OpenAI. Jeśli robot nie odwiedza Twoich ważnych stron, nie ma ich w indeksie OpenAI.
- Nadal buduj pozycje w Google. ChatGPT wciąż sięga po wyniki Google, więc strona wysoko w Google ma większą szansę trafić do odpowiedzi.
- Pokazuj datę publikacji i aktualizacji. Według Peec AI indeks zapisuje datę publikacji, a przy wiadomościach dzieli wyniki według wieku.
- Przy sklepie pilnuj danych produktów. Zakupy to miejsce, gdzie OpenAI najmocniej testuje własny indeks.
Jeśli prowadzisz lokalny biznes, według Peec AI dane z Map Google docierają do ChatGPT przez zewnętrznych dostawców. Wizytówka Google zostaje więc podstawą, a profil na TripAdvisorze warto mieć w porządku, jeśli z niego korzystasz.
FAQ
Czy ChatGPT korzysta z Google?
Tak, ChatGPT nadal korzysta z wyników Google. Według The Information OpenAI pobiera je przez SerpApi, a według Peec AI także przez innych dostawców danych. Test w Search Console pokazał skok ruchu strony z Google w dni, gdy pytano o nią tylko ChatGPT. Obok tego OpenAI buduje własny indeks.
Skąd ChatGPT bierze informacje?
ChatGPT bierze informacje z dwóch miejsc: z wiedzy zapisanej w modelu podczas trenowania i z wyszukiwania w internecie. Przy wyszukiwaniu korzysta z własnego indeksu i pamięci podręcznej OpenAI oraz z zewnętrznych dostawców, w tym wyników Google i usług Microsoftu. Źródła pokazuje przy odpowiedzi jako linki.
Co to jest OAI-SearchBot?
OAI-SearchBot to robot OpenAI, który pobiera strony do wyszukiwania w ChatGPT. Nie służy do trenowania modeli – do tego jest GPTBot. Strony, które zablokują OAI-SearchBot w robots.txt, nie pojawią się w odpowiedziach z wyszukiwania w ChatGPT.
Źródła: pomoc OpenAI, „Offline web search for ChatGPT workspaces” (help.openai.com); dokumentacja OpenAI o narzędziu web search w API i o robotach (developers.openai.com); Peec AI, Tomek Rudzki, „ChatGPT built its own search index” (4.09.2026).
LLMrefs, „OpenAI Has A Cached Index For ChatGPT Search” (2.12.2025); Tom's Guide za The Information o SerpApi (sierpień 2025); Search Engine Watch (4.09.2026); Search Engine Land o Microsoft Web IQ.
Google, „How Search Works” (wielkość indeksu); CNBC i Windows Central o zeznaniu Satyi Nadelli (2.10.2023); Fortune i Investing.com o nakładach Alphabet (2026); TechCrunch o zobowiązaniach OpenAI (6.11.2025); Capstone o wyroku w sprawie Google (2.09.2025); Cloudflare (1.07.2025); Botify i Search Engine Journal, analiza Chrisa Longa (kwiecień 2026). Stan na 28.09.2026.